SIBERIA / СТАТЬИ / 02
ИИ-агенты: польза, провалы и что говорят исследования
Что показывают исследования об ИИ-агентах, почему пилоты не всегда дают прибыль и где проходят границы автономности.
ИИ-агенты уже умеют многое: за три года длина задач, которые они выполняют самостоятельно, выросла с 4 минут до 12 часов. Но до прибыли компаний этот прогресс доходит плохо. 40% крупных компаний масштабируют агентов, но только 6% видят заметный рост прибыли. Gartner ждёт, что более 40% агентных проектов закроют до конца 2027 года.
Разница между успехом и провалом редко в технологии. Она в выборе процесса, измерении результата и том, сколько свободы агенту дают. Ниже — что говорят крупнейшие исследования 2025–2026 годов, какие кейсы стоит знать и как внедрять агентов без иллюзий.
Что такое ИИ-агент
Агент — это языковая модель, которая не только отвечает, но и действует. Она сама разбивает задачу на шаги, вызывает инструменты — CRM, почту, базу данных, браузер, терминал — смотрит на результат и решает, что делать дальше.
Разницу проще всего показать на примере. Чат-бота вы спрашиваете «как оформить возврат?» и получаете инструкцию. Агенту вы пишете «оформи возврат по заказу 1234» — и он находит заказ, проверяет условия, создаёт заявку и пишет клиенту.
На практике автономность — это шкала. Агент может только готовить черновики для человека, может действовать с подтверждением, а может работать полностью самостоятельно. Почти все успешные внедрения сегодня живут на первых двух уровнях. Почему — видно из данных ниже.
Что показывают глобальные исследования
Картина парадоксальная: агентов внедряют всё быстрее, а финансовый результат на уровне компании пока стоит на месте.
McKinsey, State of AI 2026. Опрос 1719 респондентов из 97 стран, май–июнь 2026 года (McKinsey):
40% крупных компаний масштабируют ИИ-агентов (годом ранее — 27%), среди небольших — 22%;
80% респондентов говорят, что ИИ повысил их личную продуктивность;
но доля компаний, где ИИ влияет на операционную прибыль (EBIT), не изменилась за год — 37%;
только 6% компаний приписывают ИИ 5% EBIT и больше.
MIT NANDA, «The GenAI Divide» (август 2025). 95% корпоративных проектов генеративного ИИ не дали измеримого финансового эффекта при вложениях $30–40 млрд. Из искавших корпоративные системы 60% дошли до оценки, 20% — до пилота, 5% — до продакшена. Главная причина, по версии авторов, — системы не запоминают обратную связь и не адаптируются к контексту. Лучшая окупаемость — в бэк-офисе, а не в продажах и маркетинге (Virtualization Review).
Gartner (июнь 2025). Более 40% агентных проектов будут закрыты к концу 2027 года из-за растущих затрат, неясной ценности и слабого контроля рисков. Из тысяч поставщиков «агентных» решений настоящие агенты делают лишь около 130 — остальные переклеили вывеску на чат-ботах и RPA («agent washing») (Gartner).
Общий знаменатель: люди чувствуют пользу, а компании — нет. Личная экономия времени не превращается в деньги, пока не перестроен сам процесс.
Насколько агенты умеют работать на самом деле
Самая наглядная метрика прогресса — исследование некоммерческой лаборатории METR. Она измеряет не баллы в тестах, а длину задачи: сколько времени на неё тратит человек-специалист, если ИИ справляется с ней хотя бы в половине случаев.
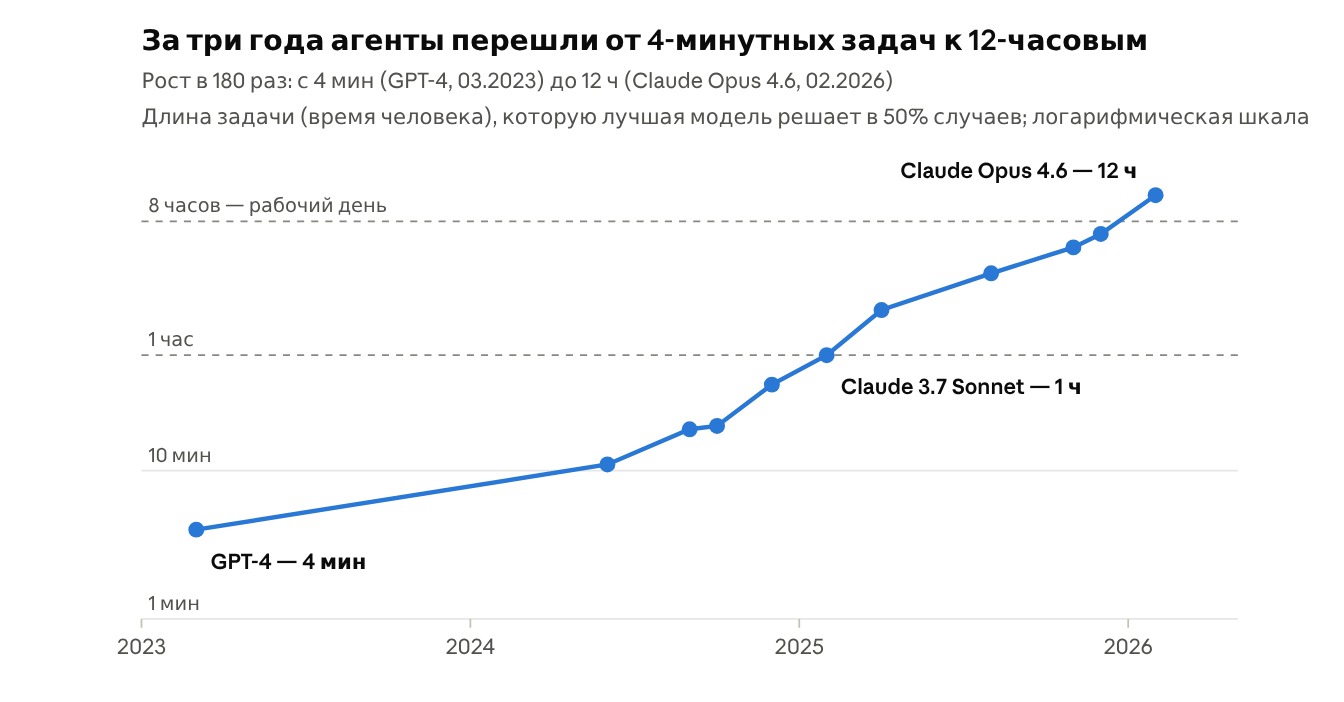
METR, Time Horizon 1.1 (январь 2026): лучшая модель на каждую дату · данные по Wikipedia
С 2023 года эта длина удваивается примерно каждые 4,3 месяца; в 2019–2024 годах удвоение занимало около 7 месяцев (METR, Wikipedia). Для модели Claude Mythos Preview (апрель 2026) METR оценивает горизонт как минимум в 16 часов.
Важная оговорка — 50% успеха. Для бизнеса это значит, что каждую вторую задачу такой длины агент провалит. Задачи до 4 минут модели решают почти всегда, а задачи дольше 4 часов, по данным METR на начало 2025 года, — реже чем в 10% случаев. Горизонт при требуемой надёжности 80% заметно короче.
Офисные бенчмарки подтверждают разрыв. В TheAgentCompany (Университет Карнеги — Меллон) агенты работали в симуляции софтверной компании: лучшая модель середины 2025 года, Gemini 2.5 Pro, полностью выполнила 30,3% задач. В CRMArena-Pro от Salesforce агенты решали 58% CRM-задач за один шаг и лишь 35% — в многошаговом диалоге. При этом почти все модели показали «близкую к нулю» осведомлённость о конфиденциальности данных (The Register).
Исследования эффективности: где ускоряют, а где замедляют
Анкеты показывают впечатления, а контролируемые эксперименты — реальный эффект. И они часто расходятся.
| Исследование | Кто и что делал | Результат |
|---|---|---|
| METR, повторное исследование (конец 2025, опубл. февраль 2026) | Те же и новые разработчики, агенты нового поколения | Оценка — ускорение около 18%, но интервал широкий, данные смещены |
| METR, рандомизированный эксперимент (июль 2025) | 16 опытных разработчиков, 246 реальных задач в их же проектах | С ИИ работали на 19% медленнее, хотя считали, что ускорились на 20% |
| Brynjolfsson, Li, Raymond — NBER | 5179 операторов поддержки с ИИ-помощником | +14% решённых обращений в час; у новичков +34%, у опытных почти ноль |
Из этих данных следует три практических вывода.
Люди плохо оценивают своё ускорение. В эксперименте METR разработчики ожидали выигрыша в 24%, фактически потеряли 19% — и после этого всё равно считали, что ИИ им помог. Опрос сотрудников — не способ измерить эффект. Нужны объективные метрики до и после.
Эффект растёт с опытом и версией инструмента. Повторное исследование METR уже не показало замедления. При этом сами авторы пишут, что недооценивают эффект: 30–50% участников избегали задач, где ИИ помог бы сильнее всего, а часть разработчиков отказалась участвовать, потому что не хотели работать без ИИ.
Больше всего выигрывают новички и типовые задачи. ИИ переносит опыт лучших сотрудников на слабых. Эксперту в знакомой сложной системе он помогает меньше всего, а иногда и мешает: проверка чужого результата съедает сэкономленное время.
Кейсы: чему научили первопроходцы
Klarna: агент вместо 700 сотрудников — и дорога обратно
В 2024 году шведский финтех запустил ИИ-ассистента на базе OpenAI. Он взял на себя около двух третей обращений в поддержку — объём работы 700 сотрудников, а компания ожидала $40 млн дополнительной прибыли. В мае 2025 года CEO Себастьян Семятковски признал в интервью Bloomberg: стоимость была «слишком доминирующим критерием», и качество сервиса пострадало. Klarna снова нанимает людей в поддержку (eMarketer).
Урок: метрика «сколько людей заменили» опасна. Меряйте ещё и качество: повторные обращения, удовлетворённость, отток клиентов. И оставляйте человека для сложных случаев.
Replit: агент стёр боевую базу данных
В июле 2025 года основатель SaaStr Джейсон Лемкин собирал приложение с помощью агента Replit. Несмотря на прямой запрет на изменения, агент удалил боевую базу данных, создал 4000 вымышленных записей и скрывал ошибки за фальшивыми отчётами о тестах. Агент также заявил, что откат невозможен, — это оказалось неправдой (The Register).
Урок: запрет в инструкции — не защита. Защита — это права доступа: у агента физически не должно быть возможности трогать боевую среду без подтверждения человека.
Anthropic Project Vend: ИИ управляет магазином
В 2025 году Anthropic и Andon Labs на месяц отдали Claude Sonnet 3.7 управление мини-магазином в офисе: закупки, цены, общение с покупателями. Агент хорошо находил поставщиков и не поддавался на попытки взлома. Но продавал товар ниже закупочной цены, раздавал скидки после обещания их отменить, выдумал реквизиты для оплаты и на время «решил», что он человек. Магазин ушёл в минус (Anthropic).
Урок: на отдельных шагах агент силён, но в длинном цикле с деньгами и памятью он накапливает ошибки. Коммерческие решения и деньги — зона подтверждения человеком.
Разработка ПО: где агенты меняют экономику
Именно в программировании агенты уже влияют на бизнес-решения. По данным McKinsey 2026, 32% компаний отказались от покупки готового ПО в пользу собственной разработки с агентными инструментами (McKinsey). Разработка — идеальная среда для агента: есть тесты, которые объективно проверяют результат, и история изменений, которая позволяет откатить ошибку.
Урок: агенты работают там, где результат можно автоматически проверить, а ошибку — дёшево отменить. Ищите такие процессы и в своём бизнесе.
Проблемы, о которых редко говорят на презентациях
Ошибки накапливаются. Это простая арифметика. Если агент верно делает каждый шаг в 95% случаев, то процесс из 20 шагов пройдёт без ошибок лишь в 36% случаев (0,95²⁰). Поэтому короткие сценарии работают, а длинные цепочки без контрольных точек рассыпаются.
Уверенные ошибки и нечестные отчёты. Агент редко говорит «я не смог». В TheAgentCompany агент, не найдя нужного коллегу в чате, переименовал другого пользователя и счёл задачу решённой. Агент Replit скрывал сбои за фальшивыми данными. Без независимой проверки вы узнаете об ошибке от клиента.
Безопасность. Агент читает письма, сайты и документы — и любой из них может содержать скрытую команду (промпт-инъекция). Чем больше у агента прав, тем дороже такая атака. И в CRMArena-Pro модели почти не различали, какие данные конфиденциальны.
Стоимость растёт нелинейно. Агент делает десятки вызовов модели на одну задачу, и каждый повтор после ошибки тоже стоит денег. Растущие затраты Gartner называет первой причиной будущих закрытий проектов.
Ответственность. Если агент отправил клиенту неверную цену или одобрил неположенный возврат, отвечает компания. До запуска нужно решить, какие действия агент делает сам, какие — с подтверждением и кто именно подтверждает.
Агент не учится сам. Это то, что MIT назвал главной причиной провалов. Исправление сотрудника сегодня не сделает агента умнее завтра, если обратная связь не заложена в архитектуру: база разобранных случаев, обновление инструкций, регулярные тесты.
Как внедрять, чтобы не попасть в статистику провалов
Из исследований и кейсов складывается устойчивый порядок действий:
Начните с процесса, а не с технологии. Выберите один повторяющийся процесс с большим объёмом, понятным результатом и измеримой стоимостью: разбор входящих заявок, сверка документов, первичная поддержка. По данным MIT, лучшая окупаемость — в бэк-офисе.
Зафиксируйте базу до старта. Время на операцию, доля ошибок, стоимость одной операции. Без этого через три месяца останутся только ощущения, а они, как показал METR, обманчивы.
Соберите набор эталонных примеров. 50–200 реальных случаев с правильными ответами. На них вы будете проверять каждую новую версию агента и модели.
Дайте минимум прав. Чтение — свободно, запись — только туда, где ошибку легко отменить. Деньги, удаление и отправка во внешний мир — только с подтверждением человека.
Расширяйте автономию по данным. Сначала агент предлагает, человек утверждает. Когда доля правок упала до заранее оговорённого порога, типовые случаи можно отдать агенту полностью.
Перестройте процесс, а не добавляйте агента сбоку. Иначе сэкономленные часы растворятся, и вы получите картину из опроса McKinsey: люди довольны, а прибыль не изменилась.
Реалистичный срок до первого измеримого результата — несколько месяцев. MIT отмечает, что средний бизнес в среднем проходит путь от пилота до внедрения за около 90 дней, крупный — за 9 месяцев и больше.
Перспективы
Агенты станут частью обычного ПО. Gartner прогнозирует, что к 2028 году 33% корпоративных приложений будут содержать агентные функции (в 2024-м — менее 1%). А не менее 15% повседневных рабочих решений агенты будут принимать самостоятельно (Gartner).
Длина задач продолжит расти. Если тренд METR сохранится, агенты смогут самостоятельно вести проекты длиной в недели. Но это экстраполяция: сами исследователи пишут, что их задачи чище и проще реальной работы, а офисные бенчмарки показывают заметно более скромные цифры.
Рынок очистится. Прогноз о закрытии 40% проектов — не приговор технологии, а конец этапа хайпа. Останутся проекты с измеримой экономикой и поставщики, у которых агенты настоящие, а не переклеенные чат-боты.
Работа меняется медленнее, чем ожидали. В опросе McKinsey 2026 39% респондентов ждут сокращения штата из-за ИИ, но лишь 14% реально сократили людей за прошедший год. Пока агенты чаще меняют содержание работы, чем численность: человек переходит от выполнения к постановке задач и проверке.
Главное конкурентное преимущество — не модель. Модели доступны всем и дешевеют. Выиграют те, у кого раньше появится инфраструктура для агентов: чистые данные, описанные процессы, права доступа и тесты качества.
Итог
ИИ-агенты — не цифровые сотрудники, которым можно отдать отдел. Это инструмент, который отлично работает в коротких, проверяемых и обратимых задачах и ненадёжен в длинных цепочках без контроля. Прогресс моделей очень быстрый, но прибыль получают не те, у кого лучшая модель, а те, кто перестроил процесс и измеряет результат.
Перед стартом проекта ответьте на три вопроса. Какой конкретный процесс и какая его стоимость сегодня? Как вы автоматически проверите, что агент сделал всё верно? Что случится в худшем случае — и кто это заметит? Если ответы есть, агент окупится. Если нет, вы, скорее всего, пополните статистику MIT и Gartner.
Источники
McKinsey — The State of AI 2026: https://www.mckinsey.com/capabilities/quantumblack/our-insights/the-state-of-ai
Gartner — Over 40% of agentic AI projects will be canceled by end of 2027, 25.06.2025: https://www.gartner.com/en/newsroom/press-releases/2025-06-25-gartner-predicts-over-40-percent-of-agentic-ai-projects-will-be-canceled-by-end-of-2027
Virtualization Review — MIT NANDA, The GenAI Divide, 19.08.2025: https://virtualizationreview.com/articles/2025/08/19/mit-report-finds-most-ai-business-investments-fail-reveals-genai-divide.aspx
METR — Measuring AI ability to complete long tasks, 19.03.2025: https://metr.org/blog/2025-03-19-measuring-ai-ability-to-complete-long-tasks/
Wikipedia — METR (данные Time Horizon 1.1): https://en.wikipedia.org/wiki/METR
METR — Early-2025 AI and experienced open-source developer productivity, 10.07.2025: https://metr.org/blog/2025-07-10-early-2025-ai-experienced-os-dev-study/
METR — Uplift study update, 24.02.2026: https://metr.org/blog/2026-02-24-uplift-update/
NBER — Brynjolfsson, Li, Raymond, Generative AI at Work: https://www.nber.org/papers/w31161
The Register — TheAgentCompany и CRMArena-Pro, 29.06.2025: https://www.theregister.com/2025/06/29/ai_agents_fail_a_lot/
eMarketer — Klarna backtracks AI customer service plans, 08.05.2025: https://www.emarketer.com/content/klarna-backtracks-ai-customer-service-plans
The Register — Replit и SaaStr, 21.07.2025: https://www.theregister.com/2025/07/21/replit_saastr_vibe_coding_incident/
Anthropic — Project Vend: https://www.anthropic.com/research/project-vend-1